
בדיקת שיעורי בית בכתב יד עם AI: מה המחקר מגלה
GPT-5 בדק 342 מבחנים בכתב יד בחדו”א. מה עבד, מה לא, ולמה האמינות נקבעת במה שנשלח למורה, ומה זה אומר על שיעורי בית במרכז לימוד.
 29.10.2026
9 דקות קריאה
כל מי שמנהל מרכז לימוד שאל את עצמו השנה את אותה שאלה: אם AI יודע לפתור תרגיל בחדו”א, למה הוא לא יכול לבדוק את שיעורי הבית של התלמידים במקום המורים?
התשובה הקצרה: הוא יכול לבדוק. השאלה היא על אילו ציונים שלו אפשר לסמוך.
התשובה הארוכה נמצאת במחקר שפורסם ב־ETH ציריך, אחת האוניברסיטאות הטכניות המובילות באירופה. החוקרים נתנו ל־GPT-5 לבדוק מבחנים אמיתיים בכתב יד, ובדקו בדיוק את השאלה הזו. במאמר הזה נעבור על מה שהם מצאו, מה זה אומר על בדיקת שיעורי בית, ואיך בנינו את StepWise Center סביב התשובה.
המחקר בקצרה
| מי | Gerd Kortemeyer, Alexander Caspar ו־Daria Horica, ETH ציריך |
| מה נבדק | החלקים הפתוחים, בכתב יד, במבחן סוף שנה בחשבון דיפרנציאלי ואינטגרלי, לסטודנטים שנה א’ לביולוגיה, כימיה ומדעי הבריאות |
| היקף | 342 מבחנים סרוקים, ו־6,631 החלטות של מתרגלים לפי המחוון ששימשו כ”תשובה הנכונה” |
| איך | GPT-5 קיבל את אותו מחוון שקיבלו המתרגלים, ובדק עמוד אחר עמוד |
| סטטוס | מאמר שפורסם כטיוטה מקדימה (preprint) ב־arXiv, נובמבר 2025 |
זה לא ניסוי מעבדה על תרגילים שהומצאו לצורך המחקר. אלה מבחנים אמיתיים, בכתב יד אמיתי, עם מחיקות, חצים וכתב שלא תמיד קל לקרוא. בדיוק כמו המחברות שמגיעות למרכז לימוד בערב.
ממצא 1: קרוב, אבל לא מספיק
בלי שום סינון, הציונים של ה־AI היו קרובים לציונים של המתרגלים. קרובים, אבל לא זהים: הציון הממוצע של המתרגלים היה 7.35, ושל ה־AI 7.89. כלומר, ה־AI היה קצת יותר נדיב.
המסקנה של החוקרים מדויקת: התוצאה הזו מספיקה למשוב במצבים שבהם ההשלכות נמוכות, אבל לא לשימוש בהחלטות שיש להן משקל.
למה זה חשוב פדגוגית
בהערכה מבחינים בין שני סוגים:
- הערכה מעצבת נועדה לעזור ללמוד. היא אומרת לתלמיד איפה הוא עומד ומה הצעד הבא. שיעורי בית הם המקרה הקלאסי.
- הערכה מסכמת נועדה להחליט: ציון סופי, מעבר שלב, תעודה.
לכל סוג יש רף אמינות אחר. במבחן מסכם, טעות בציון היא בעיה של הוגנות. בשיעורי בית, משוב שמגיע אחרי שבוע הוא לעתים קרובות בעיה גדולה יותר מנקודה אחת לא מדויקת, כי עד שהמשוב מגיע התלמיד כבר בנושא הבא.
ה־Education Endowment Foundation הבריטי, שמסכם מחקרים על דרכי הוראה, מסמן משוב כבעל “השפעה גבוהה בעלות נמוכה מאוד”. R-01
הממצא מתייחס למחקרים על משוב בבתי ספר, לא למוצר כלשהו.
שיעורי בית הם בדיוק המקום שבו בדיקה עם AI יכולה להביא הכי הרבה ערך. אבל רק אם ברור מה יוצא לתלמיד לבד ומה עובר למורה.
ממצא 2: האמינות נקבעת בסף, לא במודל
זה הלב של המחקר. החוקרים לא ניסו לשפר את ה־AI. הם הוסיפו לו מסנן, שמחליט על כל ציון אם לקבל אותו או להעביר אותו לאדם. למסנן שני תנאים:
- סף ניקוד: ציון נמוך מסף מסוים עובר לבדיקה של אדם.
- מדד סיכון: החוקרים השתמשו במודל סטטיסטי (IRT) שמעריך, לפי כל המבחן של הסטודנט, איזה ציון צפוי לו בכל פריט. אם הציון של ה־AI רחוק מדי מהציפייה, הוא חריג, והוא עובר לאדם.
במילים של מורה: אם תלמיד חזק פתאום “נכשל” בשאלה קלה, או תלמיד חלש “הצליח” בשאלה קשה, שווה לבדוק שוב לפני שמאשרים.
ואז הם שיחקו עם הספים:
| הגדרת המסנן | כמה התקבל אוטומטית | התאמה לציוני המתרגלים |
|---|---|---|
| בלי מסנן | הכל | קרובה, ה־AI מעט נדיב יותר. מספיק למשוב, לא להחלטה |
| מסנן מקל | 81% מהפריטים | טובה יותר |
| מסנן מחמיר | כ־30% מהבדיקה בלבד | כמעט זהה לציוני המתרגלים |
כלומר, אפשר לקבל ציונים כמעט זהים לאלה של המתרגלים. המחיר: רוב העבודה חוזרת לאדם. החוקרים כותבים במפורש שבמבחן הזה, תוצאות שמתאימות לשימוש אמיתי הושגו רק בכ־30% מעומס הבדיקה.
השאלה “כמה ה־AI מדויק” היא השאלה הלא נכונה. השאלה הנכונה היא מה עובר למורה, ולפי איזה כלל. אותו מודל בדיוק יכול להיות אמין מאוד או מסוכן, תלוי בכלל הזה.
ממצא 3: לפני שבודקים, צריך לקרוא
כשהחוקרים פירטו את המגבלות, חלק גדול מהן לא היה קשור לשיפוט המתמטי של ה־AI. הן היו קשורות לקריאה:
- עבודה שנכתבה מחוץ לאזור התשובה או על דף נוסף עלולה להתפספס, כי הבדיקה נעשתה עמוד אחר עמוד.
- משבצות ברקע ומחיקות מקשות על הקריאה.
ולכן ההמלצות שלהם נשמעות כמו הוראות למורה בכיתה: אזורי תשובה מסומנים בבירור, בלי משבצות ברקע, ועיפרון עם מחק במקום קשקוש על מה שנמחק.
זה בדיוק ההבדל שתיארנו במאמר על ודאות בבדיקה: כשמערכת בודקת מחברת מצולמת, היא עונה על שתי שאלות שונות.
- האם קראתי נכון את מה שהתלמיד כתב? זו ודאות הקריאה. היא יורדת בכתב לא ברור, במחיקות או בצילום חתוך.
- האם הציון וההערה נכונים לפי המחוון? זה הביטחון בבדיקה. הוא יורד בדרך פתרון לא מוכרת או בתשובה חלקית.
ב־StepWise Center שני המדדים נמדדים בנפרד, והנמוך מביניהם קובע לאן העבודה הולכת. אם הקריאה לא ודאית, גם ציון שהמערכת בטוחה בו לא משתחרר. וכבר לפני ההגשה, כשהתלמיד מצלם את שיעורי הבית, המערכת בודקת שאפשר לקרוא כל תרגיל. תרגיל חתוך מקבל בקשה לצלם שוב.
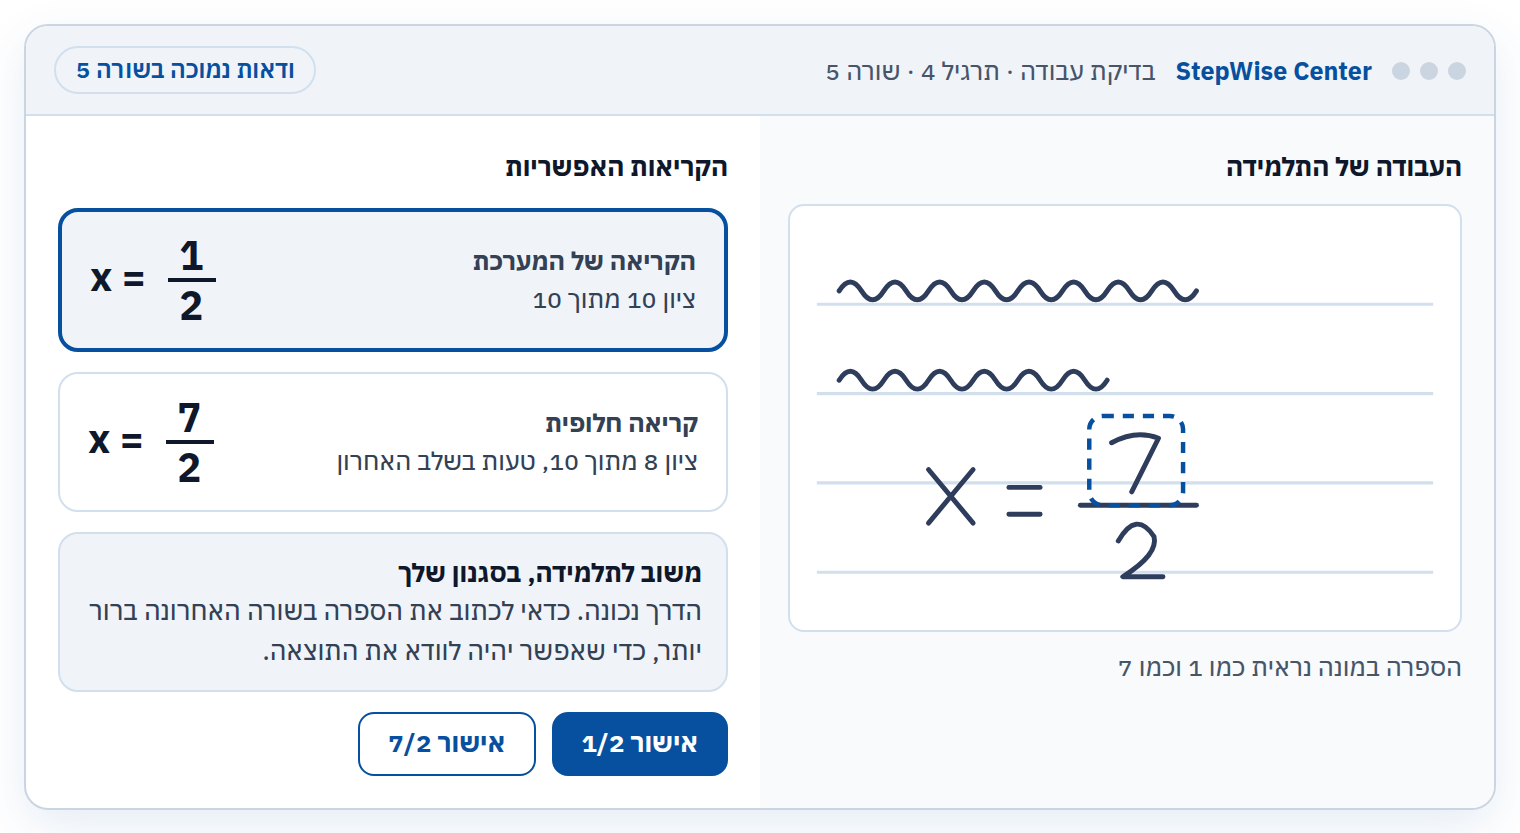
דוגמה: ספרה אחת
תארו לעצמכם תלמידה שכתבה בסוף הפתרון שבר שאפשר לקרוא כ־1/2 או כ־7/2. המערכת קראה 1/2, אבל הוודאות בשורה הזו נמוכה. במקום לנחש, העבודה מגיעה למורה. הוא רואה את שתי הקריאות ואת הציון לכל אחת, בוחר, והמשוב לתלמידה יוצא בסגנון שלו. (הדוגמה להמחשה בלבד.)
ממצא 4: מחוון שרואה את השלבים
המלצה נוספת של החוקרים: לפרק פתרונות רב־שלביים לתת־שלבים שהמחוון “רואה”. מחוון עם מעט נקודות בדיקה נותן ל־AI מעט מאוד לאחוז בו, וגם מקשה לזהות מתי משהו חריג.
לכך יש גם היגיון פדגוגי מוכר: מחוון בשלבים מלמד את התלמיד שהדרך חשובה, לא רק התשובה. הוא גם מאפשר משוב מדויק: “הצבת נכון בנוסחה, הטעות בשלב השלישי”.
ב־StepWise Center המורה בונה מחוון בשלבים עם ניקוד, והטעויות הנפוצות בכל תרגיל מקושרות לכללים מהשיטה שלו. הכללים יכולים להיות משותפים לכל המרכז או אישיים למורה, וכך גם סגנון המשוב.
ומה עם “אני בטוח”?
המסנן של ETH השתמש במדד סיכון חיצוני. מערכות רבות פשוט שואלות את המודל עצמו כמה הוא בטוח. מחקר שפורסם ב־2026 באוניברסיטת סנטרל פלורידה בדק בדיוק את זה, על שלושה מאגרי תשובות ושבעה מודלים. R-04
שני ממצאים חשובים למי ששוקל מערכת בדיקה:
- הביטחון של המודלים מוטה כלפי מעלה. בכ־86% מהבדיקות, המודל דיווח על ביטחון של 80% ומעלה. כש”בטוח מאוד” הוא ברירת המחדל, הוא לא אומר הרבה.
- את הסף צריך לכייל לכל מודל ולכל סוג משימה. תחת דרישת אמינות מחמירה, רק חלק קטן מהתשובות עבר את הסף, בערך 11% עד 20%.
וסקירה של 42 מחקרים שפורסמה ב־2026 R-05 מוסיפה תמונה רחבה: מודלים מצוינים בשאלות סגורות וקצרות, ומתקשים במטלות פתוחות, מורכבות או כאלה שדורשות שיקול דעת. לפי הסקירה, האפקטיביות הגבוהה ביותר מושגת במערכות היברידיות, שמשלבות בדיקה אוטומטית עם פיקוח ואימות של מורה.
סף אחד לכל המקצועות הוא טעות. וסף שלא נמדד מול מה שהמורים מחליטים בפועל הוא ניחוש.
איך StepWise Center מתרגמת את המחקר להחלטות עיצוב
| מה המחקר מלמד | מה זה אומר בפועל ב־StepWise Center |
|---|---|
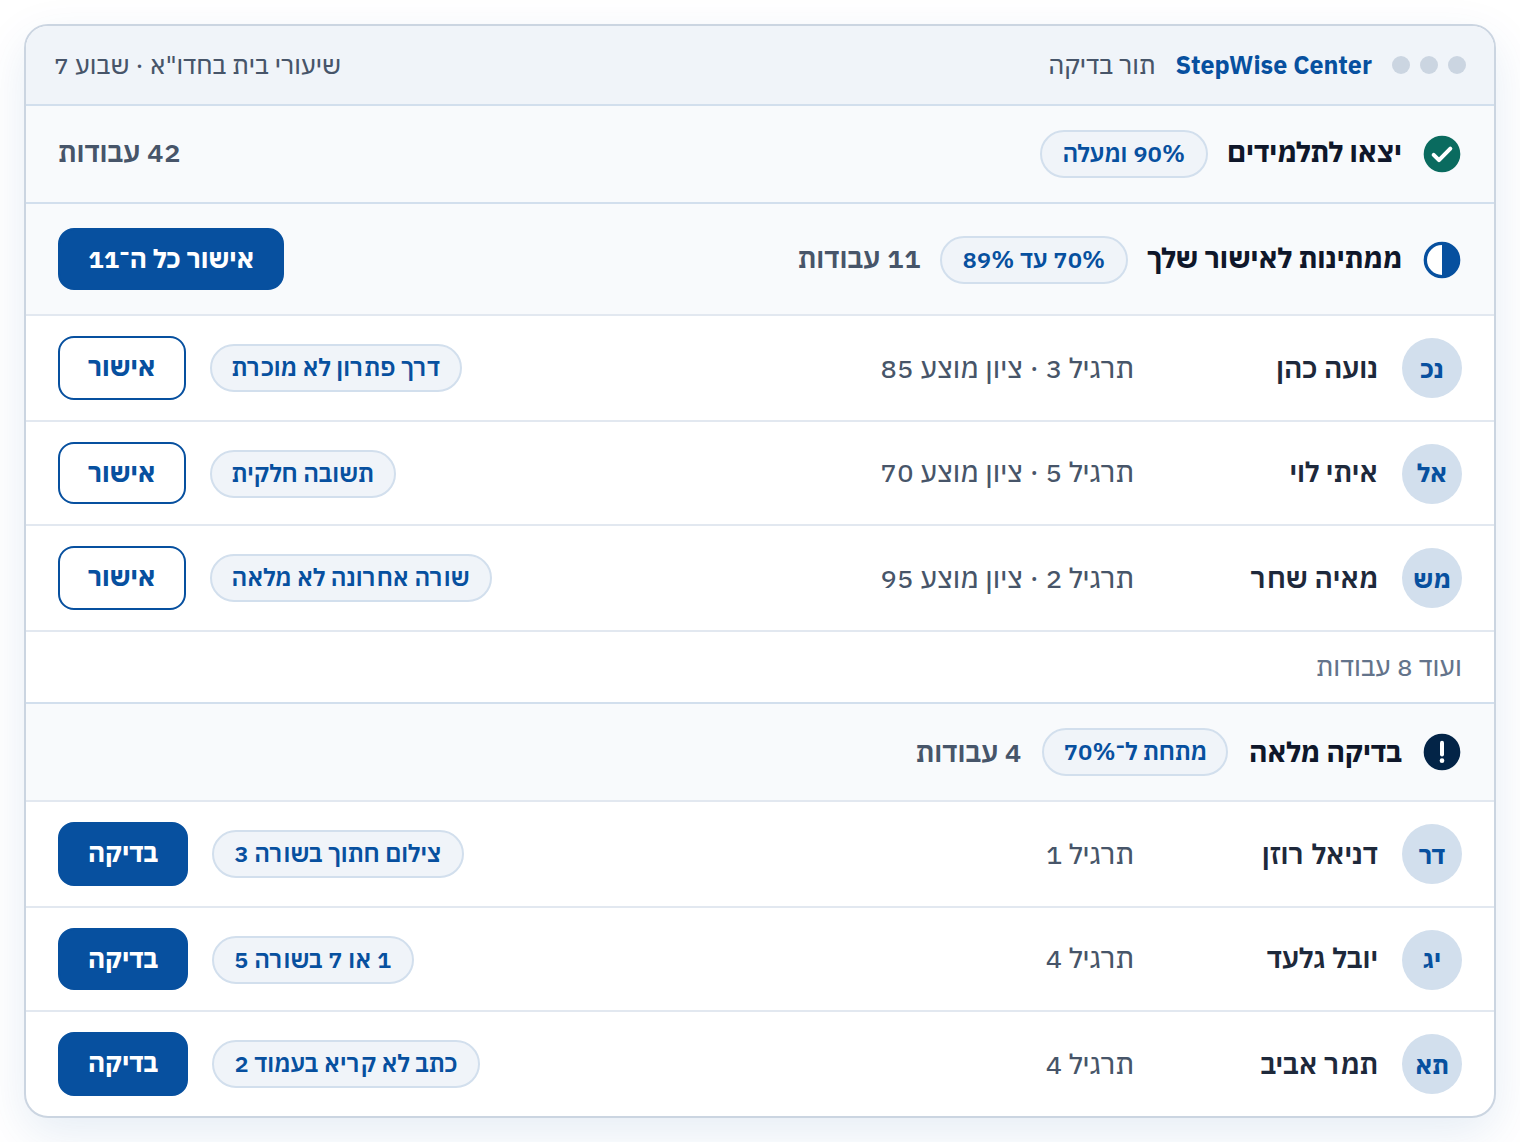
| האמינות נקבעת במה שעובר לאדם R-03 | שלושה מסלולים. 90% ומעלה: הציון והמשוב יוצאים לתלמיד מיד. 70% עד 89%: המורה רואה ציון מוצע ומאשר, אפשר כמה ברצף. מתחת ל־70%: בדיקה מלאה של המורה, עם סימון המקומות שהמערכת לא בטוחה בהם |
| קריאה ובדיקה הן שתי שאלות שונות R-03 | שני מדדים, ודאות בקריאה וביטחון בבדיקה. הנמוך קובע. בדיקת קריאוּת כבר בזמן הצילום |
| סף אחד לא מתאים לכל סוג משימה R-04 R-05 | הספים נקבעים לפי מקצוע. בהוכחות מומלץ להחמיר ל־95% |
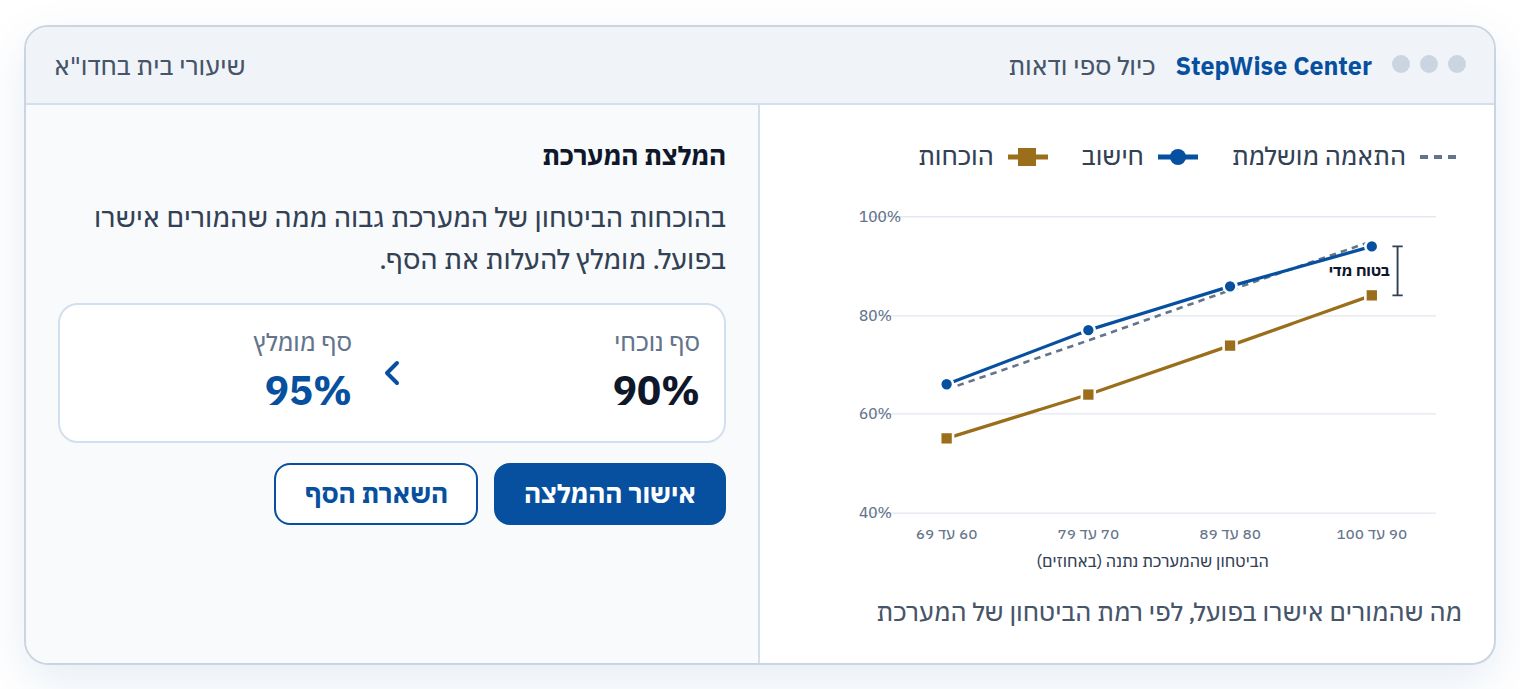
| “בטוח” צריך לבדוק מול המציאות R-04 | 5% מהעבודות שיוצאות נדגמות אקראית למורה. גרף כיול משווה בין הביטחון שהמערכת נתנה לבין מה שהמורים אישרו בפועל, לפי סוג שאלה, וכשסוג מסוים בטוח מדי המערכת ממליצה להעלות לו את הסף |
| מחוון שרואה שלבים R-03 | מחוון בשלבים עם ניקוד, וטעויות נפוצות שמקושרות לשיטה של המורה |
| הכי טוב עם פיקוח מורה R-05 | המורה קובע את הספים, רואה כל עבודה בתור, ויכול לשנות כל ציון גם אחרי שיצא. כל תיקון נרשם |
ובקוד? שם יש שני סוגי ודאות שונים. הרצת הבדיקות היא דטרמיניסטית, ולכן הוודאות בה מלאה. הערכת הדרך והקריאוּת של הקוד היא עניין של שיקול דעת, ונמדדת בנפרד. גם כאן, הנמוך קובע.
מה זה נותן למורה, ומה לתלמיד
למורה: במקום ערימה של מחברות, תור בדיקה שבו כל שורה אומרת למה היא שם, בשפה של מורה: “צילום חתוך בשורה 3”, “דרך פתרון לא מוכרת”, “1 או 7 בשורה 5”. המורה מקבל רק את מה שצריך את תשומת הלב שלו, והזמן שלו הולך לשיקול דעת ולא לבדיקה של מה שכבר ברור.
לתלמיד: משוב לכל תרגיל בסגנון של המורה, רמז שלא חושף את הפתרון, וניסיון נוסף. עד שלושה רמזים לכל תרגיל, ורמזים לא מורידים ציון. ה־AI לא נותן במתמטיקה את התשובה הסופית ולא כותב קוד במקום התלמיד. המטרה היא שהתלמיד יגיע לפתרון בעצמו.
לתלמיד ולהורה, מה הם לא רואים: אחוזי ודאות. התלמיד רואה רק אם הבדיקה סופית או שהמורה בודק. השקיפות היא על מי בדק, לא על כמה המערכת הייתה בטוחה.
מה המחקר לא אומר
כדי להשתמש במחקר נכון, חשוב לדעת גם את הגבולות שלו:
- זה מבחן אחד, בקורס אחד, באוניברסיטה אחת בשווייץ. לא שיעורי בית, ולא מרכז לימוד.
- החלק הפתוח במבחן היה בעל משקל נמוך, ולכן ייתכן שהסטודנטים השקיעו בו פחות. גם החוקרים מציינים את זה.
- מדובר בטיוטה מקדימה, שלא עברה עדיין שיפוט מלא בכתב עת.
- המחקר בדק מודל מסוים בזמן מסוים. מודלים משתנים מהר.
- StepWise Center לא נבדקה במחקרים האלה. הם לא מוכיחים שהיא עובדת. הם מסבירים למה בנינו אותה כך.
6 שאלות שכדאי לשאול כל מערכת בדיקה עם AI
לפני שמכניסים מערכת בדיקה כלשהי למרכז, כדאי לקבל תשובה ברורה על השאלות האלה:
- מי מחליט מה יוצא לתלמיד בלי מורה, ולפי איזה כלל? אם התשובה היא “ה־AI”, זה לא מספיק.
- האם הקריאה של כתב היד נמדדת בנפרד מהבדיקה עצמה? אלה שתי טעויות שונות, עם שני פתרונות שונים.
- האם הספים שונים לפי מקצוע וסוג תרגיל? הוכחה ותרגיל חישוב הם לא אותו דבר.
- איך יודעים שה”בטוח” של המערכת באמת בטוח? האם יש דגימה למורה, ומדידה מול מה שהמורים מאשרים?
- האם המורה יכול לשנות כל ציון, גם אחרי שיצא, והאם זה נרשם?
- מה התלמיד מקבל: ציון, או את הצעד הבא? רמז, ניסיון נוסף, משוב על השורה שבה טעה.
רוצים לראות את זה על המחברות שלכם?
הדרך הטובה ביותר לבדוק אם בדיקה לפי רמת ודאות מתאימה למרכז שלכם היא לראות אותה על החומרים שלכם. הביאו כמה עבודות אמיתיות ואת מספר הלומדים שלכם, ונריץ אותן יחד בהדגמה.
לתיאום הדגמהשאלות נפוצות
האם AI יכול לבדוק שיעורי בית בכתב יד?
כן, ובמחקר של ETH ציריך הציונים שלו היו קרובים לציוני המתרגלים. אבל קרוב לא מספיק לכל ציון. מה שהופך את הבדיקה לאמינה הוא הכלל שקובע אילו ציונים יוצאים לבד ואילו עוברים למורה.
מה קורה כשהמערכת טועה?
בגלל זה יש ודאות. ב־StepWise Center ציון יוצא לבד רק מעל הסף שהמרכז קבע, 5% מהעבודות שיוצאות נדגמות למורה, וכל תיקון של מורה נרשם.
אילו מקצועות StepWise Center בודקת?
מתמטיקה (כולל הוכחות, עם סף מחמיר יותר), אנגלית, מדעי המחשב (Python ו־JavaScript) ופיזיקה.
האם התלמידים רואים כמה המערכת בטוחה?
לא. תלמידים והורים רואים רק אם הבדיקה סופית או שהמורה בודק.
מקורות
- R-03Kortemeyer, G., Caspar, A., & Horica, D. (2025). Artificial-Intelligence Grading Assistance for Handwritten Components of a Calculus Exam. arXiv:2510.05162 (preprint). https://arxiv.org/html/2510.05162v2 (נפתח 23.10.2026)
- R-04Vasquez Ferrer, R., Turgut, D., Chen, Z., & Sonkar, S. (2026). When Can We Trust LLM Graders? Calibrating Confidence for Automated Assessment. arXiv:2603.29559. https://arxiv.org/html/2603.29559v1 (נפתח 23.10.2026)
- R-05Jukiewicz, M., & Wyrwa, M. (2026). Can ChatGPT Replace the Teacher in Assessment? Applied Sciences, 16(2), 680. https://www.mdpi.com/2076-3417/16/2/680 (נפתח 23.10.2026)
- R-01Education Endowment Foundation, Teaching and Learning Toolkit: Feedback. https://educationendowmentfoundation.org.uk/evidence-summaries/teaching-learning-toolkit/feedback/technical-appendix (נפתח 21.10.2026)
רק צריך להשאיר מייל ונוכל לשלוח לך עדכונים על הפיתוחים החדשים שלנו בתחום הלמידה (:** לא לדאוג, אנחנו שולחים מיילים רק כשיש לנו משהו ממש גדול ומרגש לספר עליו.
היית רוצה לדעת על פיתוח חדש שלנו לפני כולם?